
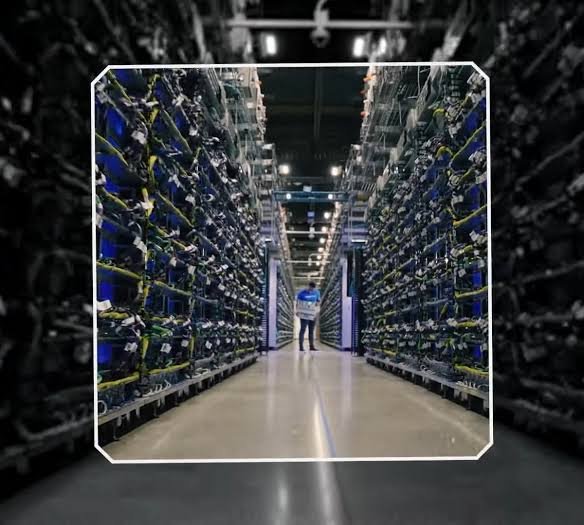
Google expande portfólio de TPUs
O Google anunciou a expansão do seu portfólio de TPUs de oitava geração com dois sistemas adicionais, TPU 8i Max e o TPU 8tx. Especializado em IA segura e de alto contexto, cada sistema tem como alvo uma etapa distinta do ciclo de vida da IA. Esta é a primeira vez que o Google introduz quatro configurações de TPU em um único ano.
O Google usa TPUs de diversas formas: treina e disponibiliza seus próprios modelos para assumir cargas de trabalho de agentes; oferece serviços aos clientes do Google Cloud em sua própria infraestrutura de nuvem; e mais recentemente, acompanhando o aumento do interesse e da demanda, permite que os clientes os implantem diretamente em seus próprios data centers. Isso tornou os TPUs um negócio em rápido crescimento com quase 100 clientes – incluindo laboratórios de ponta, empresas de negociação, varejistas, universidades e muito mais.
Anunciados pela primeira vez no Cloud Next em abril de 2026, o TPU 8t e o TPU 8i estabeleceram a referência para esta geração de chips e oferecem desempenho de treinamento até 2,7 vezes superior e relação preço/desempenho de inferência 80% melhor, respectivamente, em comparação com as gerações anteriores de TPUs. O TPU 8t foi projetado para ser uma potência de treinamento para grandes modelos fundacionais com “goodput” máximo — ou seja, a inteligência útil entregue por watt de energia utilizado. O TPU 8i é o motor de raciocínio, projetado para quebrar a barreira da memória, reduzindo os atrasos de comunicação entre chips até pela metade. Agora, à medida que as empresas levam agentes autônomos para a produção, o Google criou duas novas configurações desses sistemas fundamentais – TPU 8i Max e TPU 8tx – para resolver dois novos desafios urgentes: segurança de dados no nível de hardware e escala de contexto de milhões de tokens.
“Com a computação migrando da escala humana para a escala de agentes, as empresas estão pedindo aceleradores que possam raciocinar sobre as massivas janelas de contexto dos modelos de IA. Além disso, alguns clientes, altamente regulamentados, estão pedindo recursos de criptografia especializados para cargas de trabalho únicas”, disse Amin Vahdat, Diretor de Tecnologia e Vice-Presidente Sênior de IA e Infraestrutura do Google. “Esses novos sistemas TPU abordam essa nova realidade. Combinados com nossos anúncios recentes sobre o PyTorch, nosso objetivo é tornar os TPUs mais facilmente acessíveis para cada desenvolvedor e cada cliente. Ao combinar silício personalizado modular com uma pilha de software aberta e fácil de usar, podemos entregar novas configurações de hardware e sistema no ritmo da indústria de IA.”
TPU 8tx, otimizado para inferência confidencial e treinamento em pequena escala
O TPU 8tx foi construído para empresas regulamentadas e governos que executam modelos avançados ou proprietários e agentes autônomos ao lado de seus dados mais sensíveis. Normalmente, os dados são criptografados quando armazenados ou enviados por uma rede, mas precisam ser desbloqueados na memória enquanto o computador os processa. Desenvolvido sobre o mesmo silício do TPU 8t e combinado com hosts CPU AMD personalizados, o TPU 8tx integra a segurança diretamente na camada de hardware, mantendo dados sensíveis e pesos de modelos protegidos e isolados mesmo durante o uso ativo. E, ao adotar a mesma rede Boardfly de baixa latência criada para raciocínio em tempo real, o TPU 8tx mantém os agentes de múltiplas etapas em movimento, entregando latência 2x menor em comparação com o TPU 8t com penalidade de desempenho quase nula.
Combinar computação em nível de treinamento com uma rede de inferência rápida também significa que as organizações podem executar e customizar seus modelos simultaneamente em um único sistema. O TPU 8tx permite que as equipes façam ajuste fino de modelos usando seus dados privados, destilem grandes modelos em modelos menores e treinem seus agentes por meio de aprendizado por reforço, tudo sem a necessidade de migrar dados sensíveis entre clusters separados.
TPU 8i Max, criado para superar o gargalo de memória
Quando dezenas de agentes de IA trabalham juntos em toda uma base de código de software ou em horas de vídeo de uma só vez, a largura de banda de memória torna-se rapidamente o gargalo.
O TPU 8i Max dimensiona a computação e a memória em sintonia. Isso oferece o dobro de computação, de SRAM e da largura de banda de HBM do TPU 8i, de modo que os processadores permaneçam equipados com dados essenciais e grandes cargas de trabalho não fiquem paralisadas. Além disso, como o TPU 8i Max acomoda o dobro de silício dentro da estrutura de rack existente, os data centers podem implantar significativamente mais poder de computação por metro quadrado e por watt.
Embora flexíveis em diversas cargas de trabalho, juntos, os quatro sistemas da oitava geração de TPUs do Google oferecem aos clientes um acelerador sob medida para cada etapa do ciclo de vida dos agentes. O TPU 8t para treinamento em grande escala, o TPU 8i para raciocínio de baixa latência, o TPU 8tx para computação confidencial e o TPU 8i Max para janelas de contexto massivas e maior densidade de computação por rack.
